导语|能读懂的译文和能用的译文,是两回事。前者解决“看不懂”,后者要求术语统一、符号不动、结构对得上——因为译文往往不是终点,而是下一步工作的原料。
一、语言壁垒最容易被低估
同一个研究方向,成果并不都发表在英文期刊上。德语、日语、俄语、葡萄牙语、西班牙语里的工作,常常因为“看不懂”而被跳过——跳过的人多了,这些工作就等于不存在。
把语言这一层先打通,是判断力能发挥作用的前提。
二、常见的 12 种研究语言,可以互译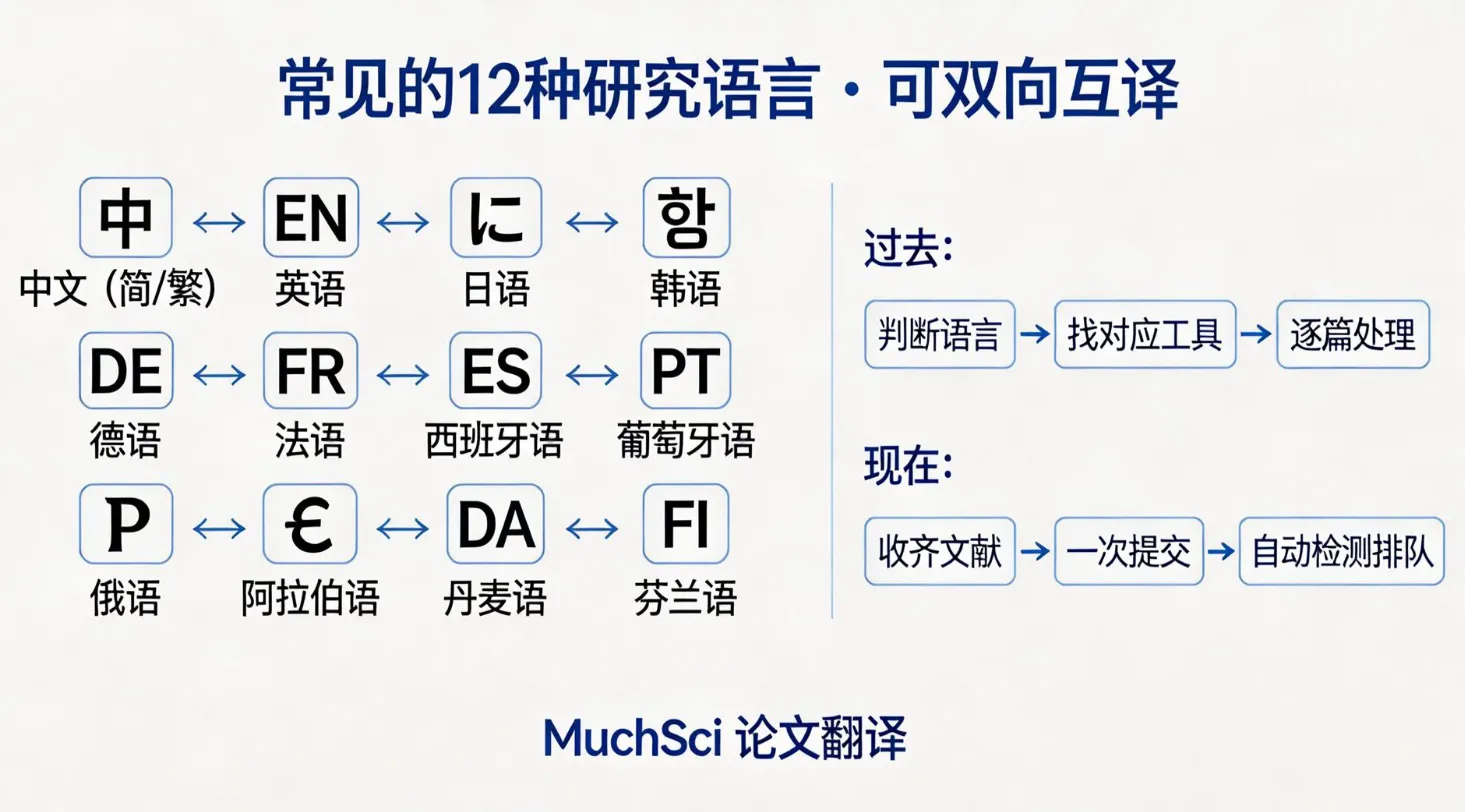
MuchSci 论文翻译支持中文(简/繁)、英语、日语、韩语、德语、法语、西班牙语、葡萄牙语、俄语、阿拉伯语、丹麦语、芬兰语这 12 种语言互译,提交时自动检测源语言。你不用先判断“这是哪国语言”,也不用去找对应的翻译工具——一次提交,逐篇排队处理。
对跨语言调研来说,这一步改变的是流程:过去是“先判断语言、再找办法读”,现在是“先收文献、统一交给它”。
三、译文要“能用”,得守住四件事
读得顺,不等于能用。真正决定译文价值的,是细节有没有被守住:
| 论文里的元素 | 翻译时该怎么处理 | 为什么 |
| 正文段落 | 逐段对应翻译 | 便于左右对照着读,不被重排打乱 |
| 专业术语 | 全文统一,必要时保留英文原词 | 术语一乱,后面提取数据就会错 |
| 图表与公式 | 保持原样,只译标题与注释 | 数字和符号改不得 |
| 参考文献 | 保留原始条目 | 作者、期刊、年份不需要翻译 |
| 摘要与结论 | 优先译 | 先判断这篇值不值得精读 |
其中最容易出问题的是术语与符号:一段话读起来很通顺,但把“改性”和“掺杂”混用,或者把单位换了写法,后面的对比就会失真。
四、翻译只是中间一站
把译文当终点,通常只读一遍就放下了;把它当中间站,事情会不一样:原文 PDF 变成可编辑的译文 txt,再从译文里抽出方法、指标、结论,最后汇成同方向的对比表或综述素材。
在实际工作里,这一步经常被显式提出来。比如提交翻译时会顺带说一句“翻译完成后,请提取关于改性方法的核心数据”——翻译和提取连着做,比先翻完再回头找要省事得多。
五、不是每一篇都值得全译
翻译能力解决的是“读懂”,解决不了“要不要读”。更省时间的做法是:先看摘要与结论,判断相关性;相关的,优先译关键章节,需要细节时再要全文;不相关的,记下标题和结论即可。
译得多,不等于读得多。 把时间留给真正相关的那几篇,才是效率。
六、翻译的终点是判断
回头看,一篇文献从外文变成能用,要走的路是清楚的:先跨过语言(自动识别、统一目标语言、逐篇处理),再守住细节(术语统一、符号不动、结构对应),最后进入提取与对比。
MuchSci 论文翻译负责的是前面这一段——把多语言、多文档的翻译变成一件很少需要你操心的事,并把结果交回成可以继续编辑的文本。至于哪一篇值得精读、哪些数据要抽出来、结论能不能支撑你的判断,仍然是你的活。
判断译文的唯一标准,其实很朴素:把它交给下一个人,他能不能直接往下用。 能,这篇译文就算完成了。