導語|能讀懂的譯文和能用的譯文,是兩回事。前者解決「看不懂」,後者要求術語統一、符號不動、結構對得上——因為譯文往往不是終點,而是下一步工作的原料。
一、語言壁壘最容易被低估
同一個研究方向,成果並不都發表在英文期刊上。德語、日語、俄語、葡萄牙語、西班牙語裡的工作,常常因為「看不懂」而被跳過——跳過的人多了,這些工作就等於不存在。
把語言這一層先打通,是判斷力能發揮作用的前提。
二、常見的 12 種研究語言,可以互譯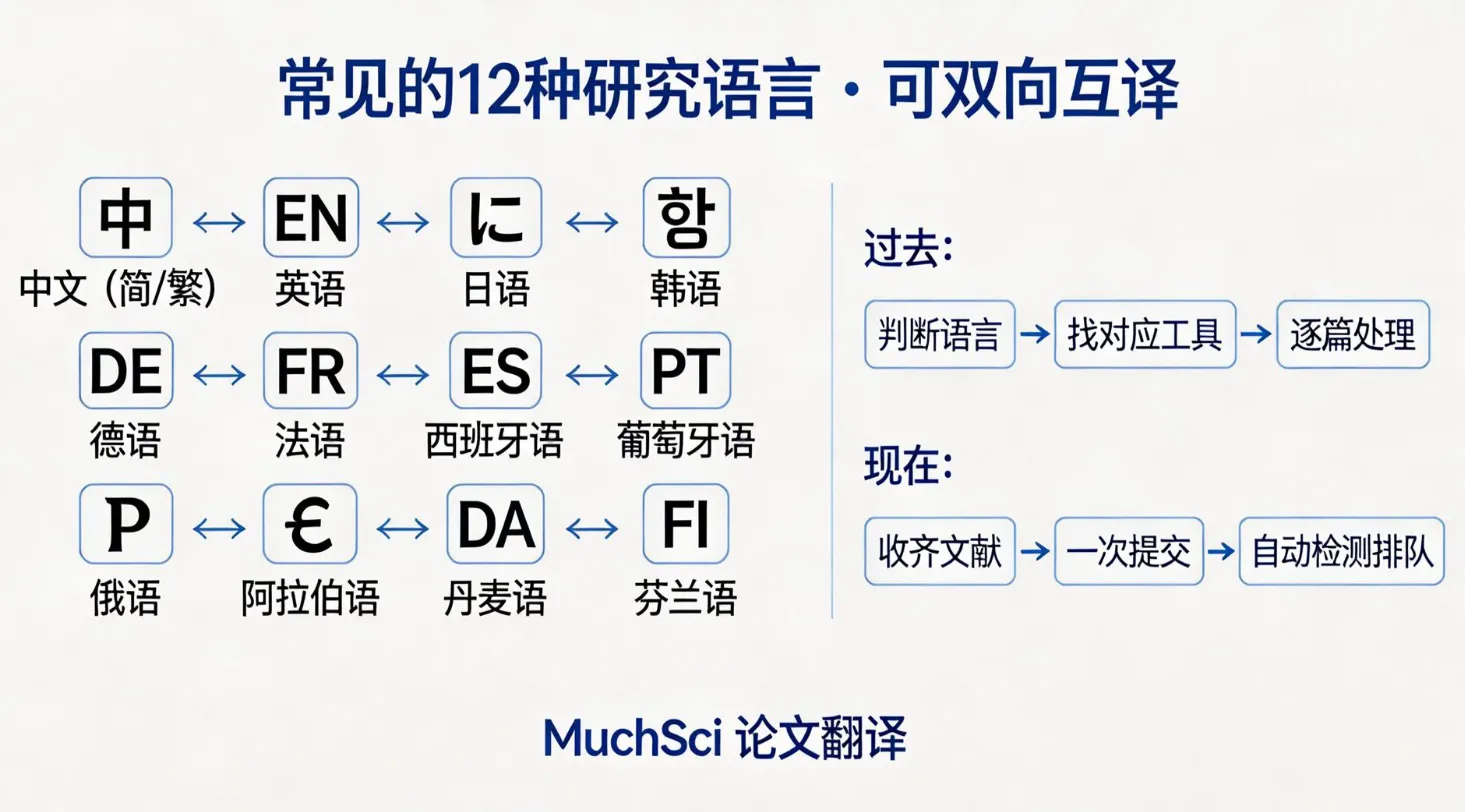
MuchSci 論文翻譯支持中文(簡/繁)、英語、日語、韓語、德語、法語、西班牙語、葡萄牙語、俄語、阿拉伯語、丹麥語、芬蘭語這 12 種語言互譯,提交時自動檢測源語言。你不用先判斷「這是哪國語言」,也不用去找對應的翻譯工具——一次提交,逐篇排隊處理。
對跨語言調研來說,這一步改變的是流程:過去是「先判斷語言、再找辦法讀」,現在是「先收文獻、統一交給它」。
三、譯文要「能用」,得守住四件事
讀得順,不等於能用。真正決定譯文價值的,是細節有沒有被守住:
| 論文裡的元素 | 翻譯時該怎麼處理 | 為什麼 |
| 正文段落 | 逐段對應翻譯 | 便於左右對照着讀,不被重排打亂 |
| 專業術語 | 全文統一,必要時保留英文原詞 | 術語一亂,後面提取數據就會錯 |
| 圖表與公式 | 保持原樣,只譯標題與註釋 | 數字和符號改不得 |
| 參考文獻 | 保留原始條目 | 作者、期刊、年份不需要翻譯 |
| 摘要與結論 | 優先譯 | 先判斷這篇值不值得精讀 |
其中最易出問題的是術語與符號:一段話讀起來很通順,但把「改性」和「摻雜」混用,或者把單位換了寫法,後面的對比就會失真。
四、翻譯只是中間一站
把譯文當終點,通常只讀一遍就放下了;把它當中間站,事情會不一樣:原文 PDF 變成可編輯的譯文 txt,再從譯文裡抽出方法、指標、結論,最後匯成同方向的對比表或綜述素材。
在實際工作裡,這一步經常被顯式提出來。比如提交翻譯時會順帶說一句「翻譯完成後,請提取關於改性方法的核心數據」——翻譯和提取連著做,比先翻完再回頭找要省事得多。
五、不是每一篇都值得全譯
翻譯能力解決的是「讀懂」,解決不了「要不要讀」。更省時間的做法是:先看摘要與結論,判斷相關性;相關的,優先譯關鍵章節,需要細節時再要全文;不相關的,記下標題和結論即可。
譯得多,不等於讀得多。 把時間留給真正相關的那幾篇,才是效率。
六、翻譯的終點是判斷
回頭看,一篇文獻從外文變成能用,要走的路是清楚的:先跨過語言(自動識別、統一目標語言、逐篇處理),再守住細節(術語統一、符號不動、結構對應),最後進入提取與對比。
MuchSci 論文翻譯負責的是前面這一段——把多語言、多文檔的翻譯變成一件很少需要你操心的事,並把結果交回成可以繼續編輯的文本。至於哪一篇值得精讀、哪些數據要抽出來、結論能不能支撐你的判斷,仍然是你的活。
判斷譯文的唯一標準,其實很樸素:把它交給下一個人,他能不能直接往下用。 能,這篇譯文就算完成了。